角色一致性:同一张脸,从第一镜走到最后一集
AI 短剧角色一致性:定妆照锁脸、关键帧做首帧、图生视频只负责动。换装、换场景也不换人。附同一角色在不同场景的样片。
换脸是 AI 短剧最常见的废片原因。观众可以接受画面不够精致,但接受不了上一镜的女主和下一镜不是同一个人。尤其是连载短剧,第一集和第十集的主角对不上,整部剧就没法看。
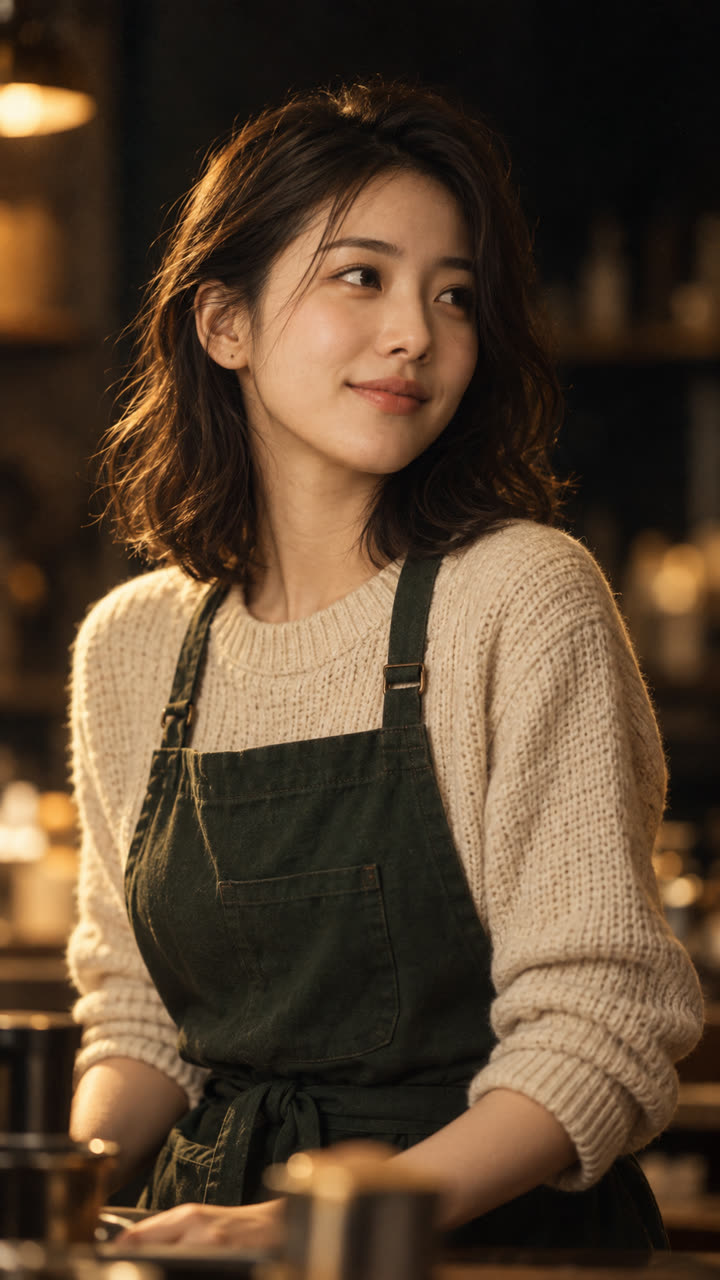
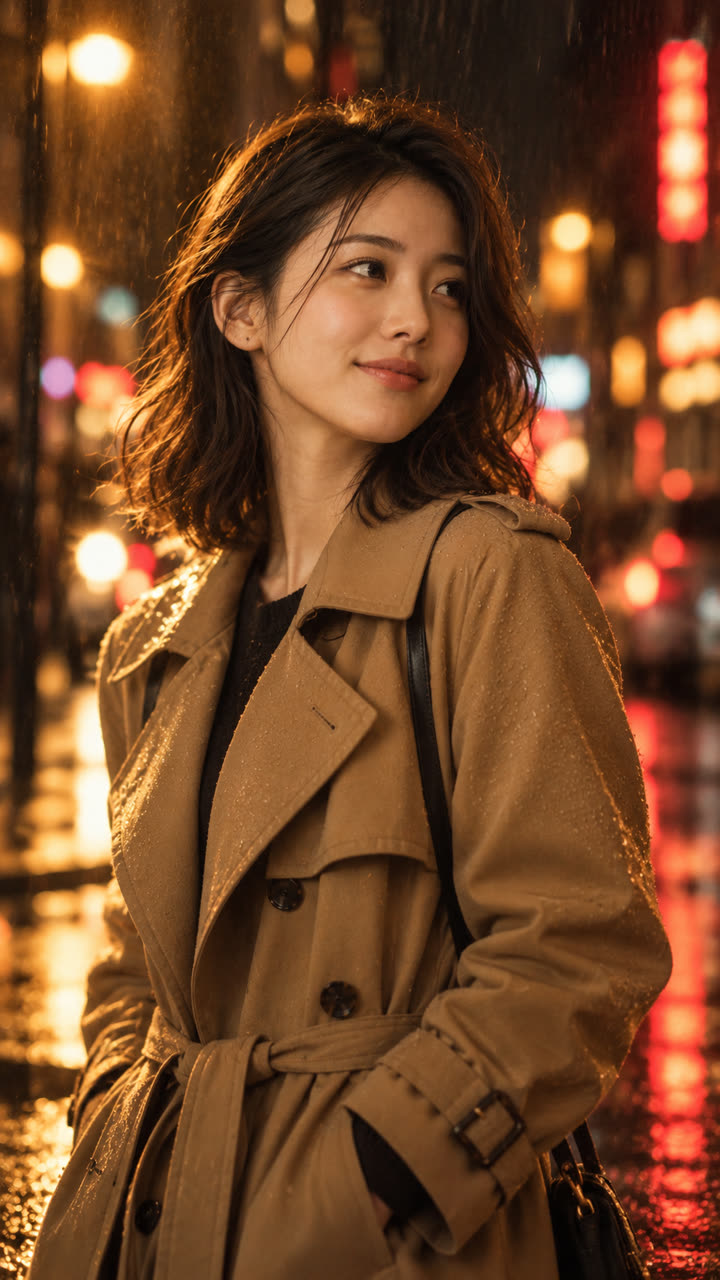
这页的样片来自同一部短剧「雨夜咖啡店」:读信、整理花束、换上风衣冲进雨夜,三个场景、两套服装,是同一个人。下面讲怎么做到的。
锁定角色的四个步骤
1把角色从剧本里提取成独立资产
角色不是写在每条提示词里的一段描述,而是一个独立的资产:名字、年龄、外形、性格、服装。剧本定稿后自动提取,也可以手动补充。之后每一镜都「引用」这个角色,而不是重新描述。
2生成定妆照:正面、侧面、不同造型
每个角色先出定妆照。样片女主有三张:毛衣围裙的正面和侧面,以及雨夜风衣造型。正面锁脸,侧面给转头和侧拍镜头做参考,不同造型对应剧情里的换装。定妆不满意就在这一步改,改定妆比改视频便宜得多。
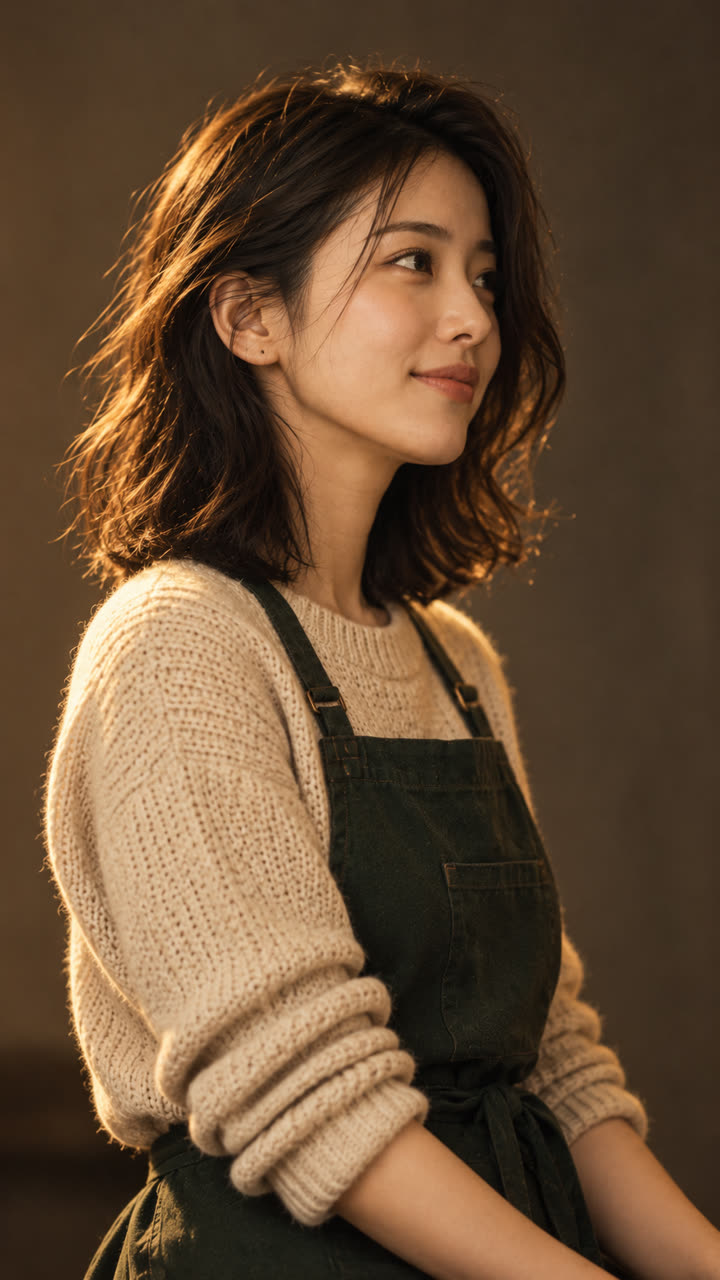
定妆:侧面 3每一镜的关键帧都引用定妆
拆分镜后,每一镜先生成关键帧,生成时把这一镜出场角色的定妆照作为参考图。关键帧确定了这一镜的构图、人物和场景,是后面视频的首帧。
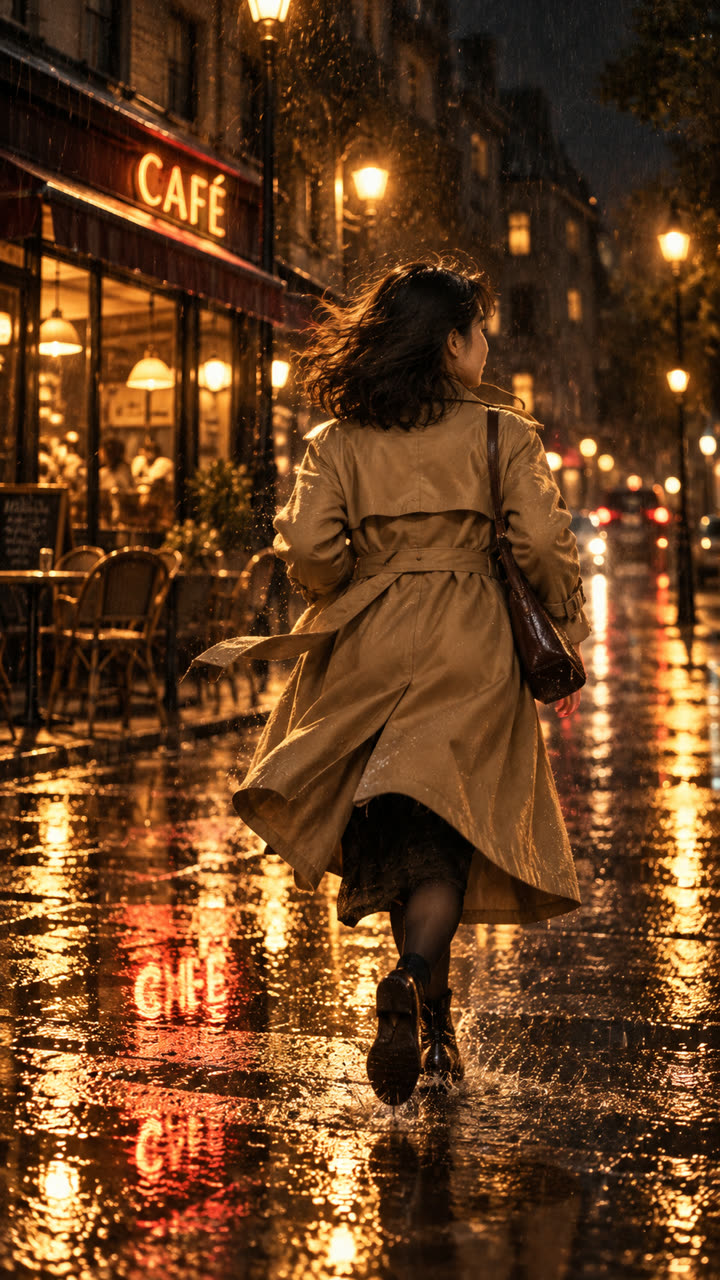
关键帧:冲进雨里 4图生视频:模型只负责动
视频用关键帧做首帧生成,提示词只写动作和运镜,比如「她低头读信,眼眶慢慢红了,镜头缓慢推近」。脸已经在首帧里定好,模型不需要再想象一遍长相。生成后还可以用助手检查,发现脸飘了就只重做那一镜。
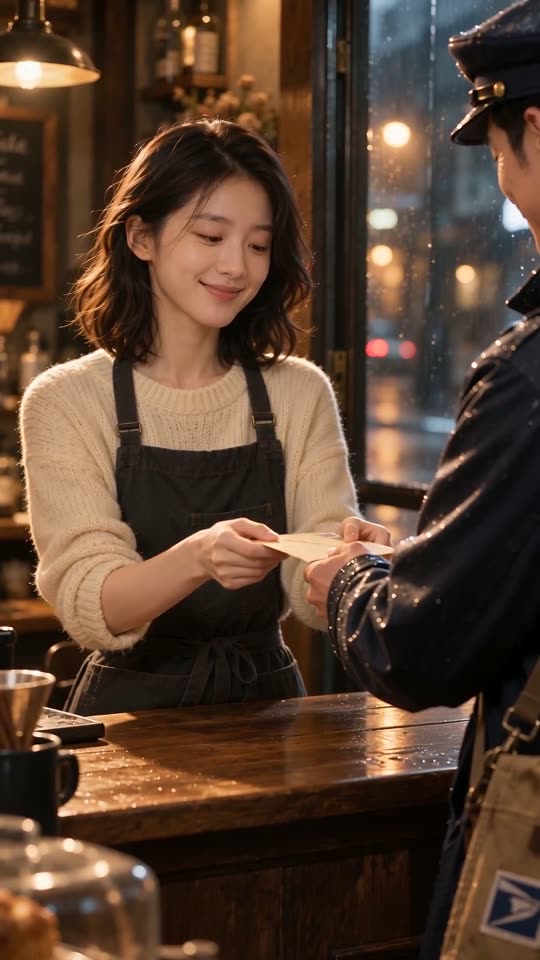
成片截帧
为什么只靠提示词锁不住脸
「黑色微卷短发、杏眼、鹅蛋脸、米色毛衣」这样的描述,对视频模型来说能对应成千上万张不同的脸。每次生成它都会挑一张,几镜之后差异越来越大。提示词写得再细,也只能缩小范围,没法锁定到同一个人。
图片是最精确的描述。把定妆照作为参考,或者用基于定妆生成的关键帧做首帧,模型看到的是同一张脸,一致性就从「碰运气」变成「默认如此」。
换装、换发型、长大变老怎么办
换的是定妆,不是换人。剧情里女主从店里的毛衣围裙换成出门的风衣,就给同一个角色加一套风衣造型的定妆,五官沿用原来的。需要这套造型的镜头引用风衣定妆,其余镜头照旧。
时间跨度大的剧情,比如「三年后」,也是同样的做法:同一个角色加一个年龄或发型不同的造型。角色资产还是一个,只是有多套定妆。
场景也要锁
只锁人不锁场景,会出现上一镜在木吧台前、下一镜吧台变成大理石的情况。场景和角色一样单独提取,生成场景图和空镜,每一镜引用同一张场景图。样片里咖啡店的门面空镜和店内镜头用的是同一套场景设定。
常见问题
换装怎么办?
换的是定妆图或服装说明,人物资产还是同一个,避免变成另一个人。
一个角色需要几张定妆?
至少一张正面。经常有侧脸和转身的角色,加一张侧面;剧情里换装的,每套造型一张。
多个角色同框会混脸吗?
同框镜头的关键帧会同时引用两个角色的定妆。人物越多越难,建议同框不超过两三人,复杂场面拆成多个镜头。
跨集还能保持一致吗?
能。角色资产属于整部剧,后面每一集都引用同一套定妆。
已经生成的视频脸不对怎么办?
只重做那一镜。先检查关键帧是否引用了正确的定妆,再重新生成视频。
接着看
今天就拍出你的第一集
注册即送体验额度。先写一句卖点,或贴一段小说试试。