先有分镜,视频模型才知道每一秒拍什么
AI 分镜教程:剧本自动拆成分镜表,每镜写景别、动作、对白、时长,生成关键帧再出视频。附三镜短剧的分镜、关键帧和成片对照。
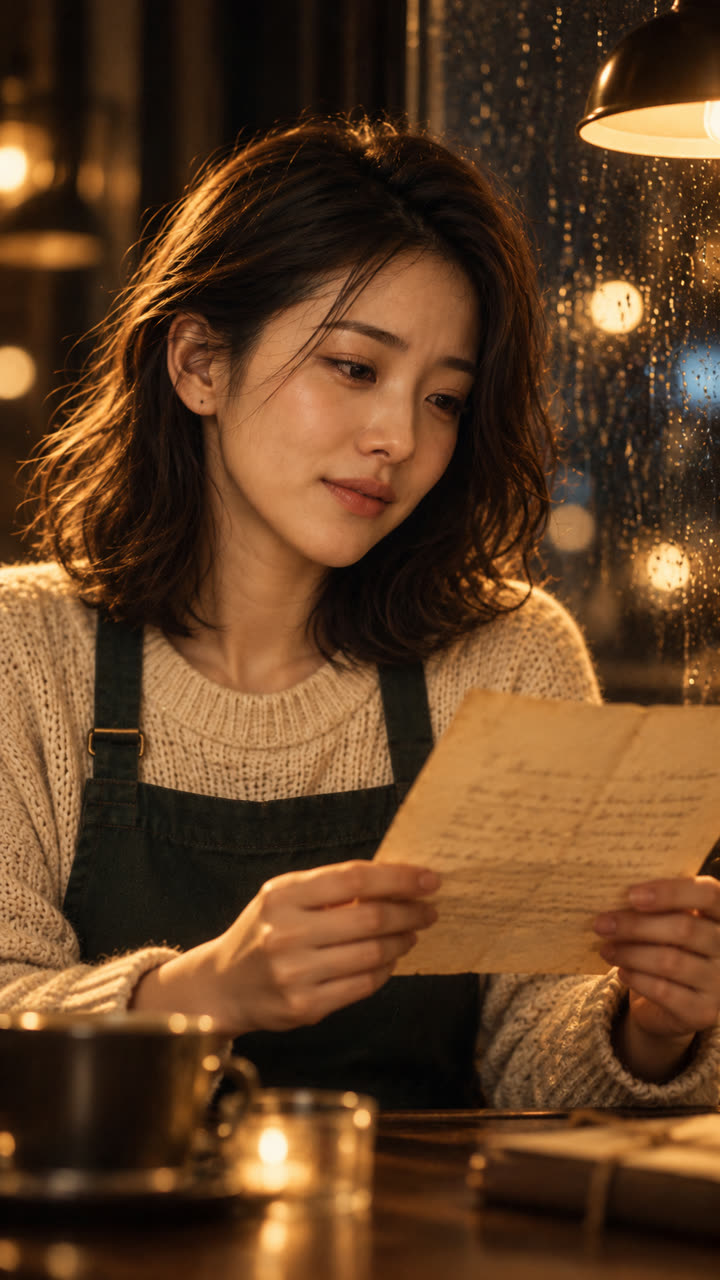
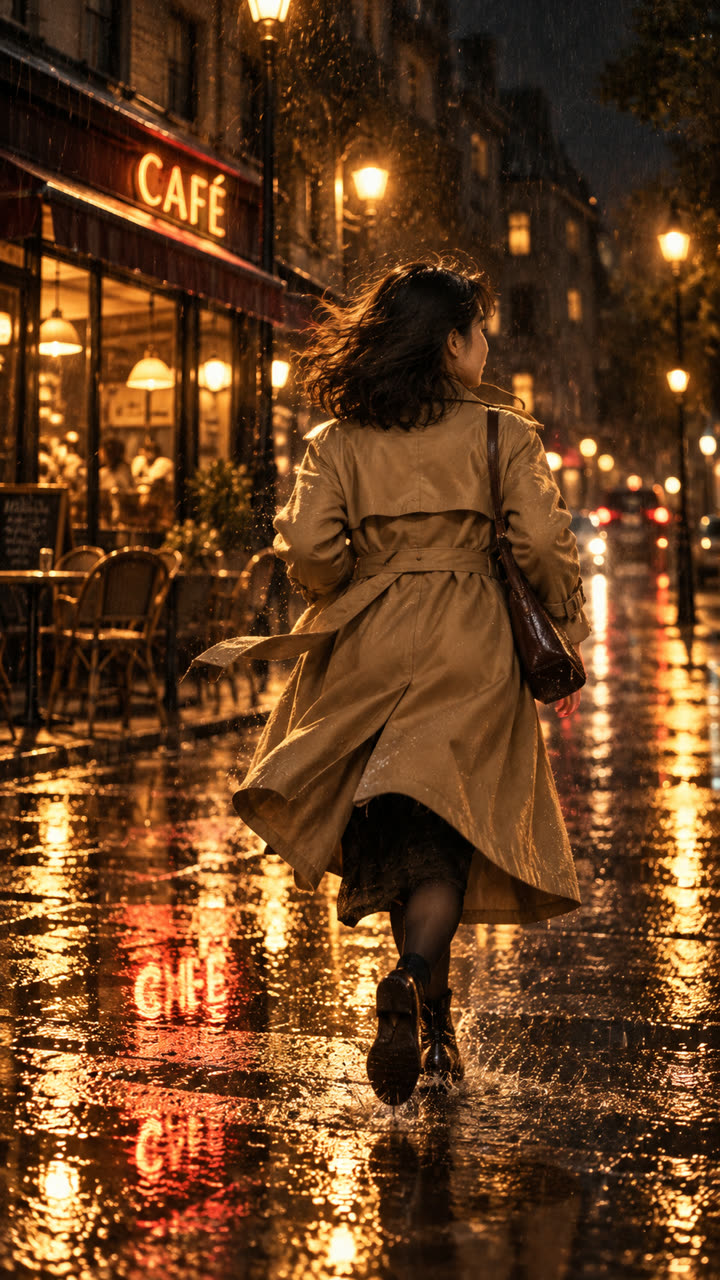
「生成一段视频:咖啡店老板娘收到一封信,哭了,跑出去」,这样的提示词交给视频模型,得到的是一条节奏随机、镜头随机的片子。把它换成分镜:第 1 镜中景,邮差把信递过柜台;第 2 镜近景,她读信,眼眶红了;第 3 镜背影,她冲进雨里。模型就知道每一秒该拍什么。
分镜是剧本和视频之间的翻译层。上面的样片就是这三镜分镜拍出来的,下面是从剧本到分镜、再到关键帧和视频的过程。
从剧本到分镜的步骤
1剧本定稿,资产就位
分镜之前,剧本要定稿,角色和场景要提取好、有定妆。分镜会引用这些资产,资产没有就先补,不然出片人物会飘。
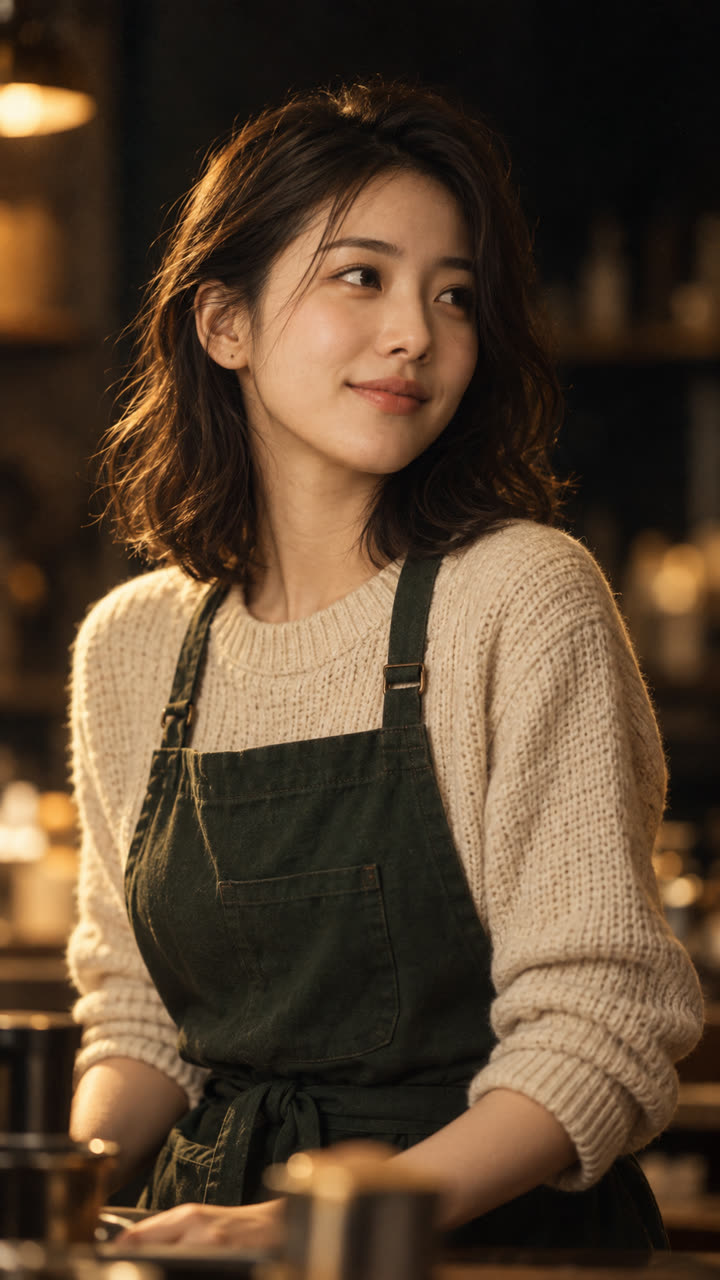
定妆:正面 2一键拆分镜
分镜助手按剧本拆出整集分镜表。每一镜包含:镜号、景别(全景、中景、近景、特写)、画面描述、人物动作、对白、时长、出场的角色和场景。拆完同时生成每一镜给视频模型用的提示词。
3检查和修改分镜
用「智能检测分镜」逐镜对照剧本,检查台词是否完整,镜头衔接、轴线、景别节奏是否合理。要改哪一镜,直接跟助手说「第 2 镜:现在是中景,改成近景,停在她的眼睛上」。也可以把一镜拆成两镜,或者合并。
4生成关键帧
每一镜按分镜描述和引用的定妆生成关键帧。关键帧排在一起,就是一份可视化的分镜板,节奏和构图一眼就能看出来。
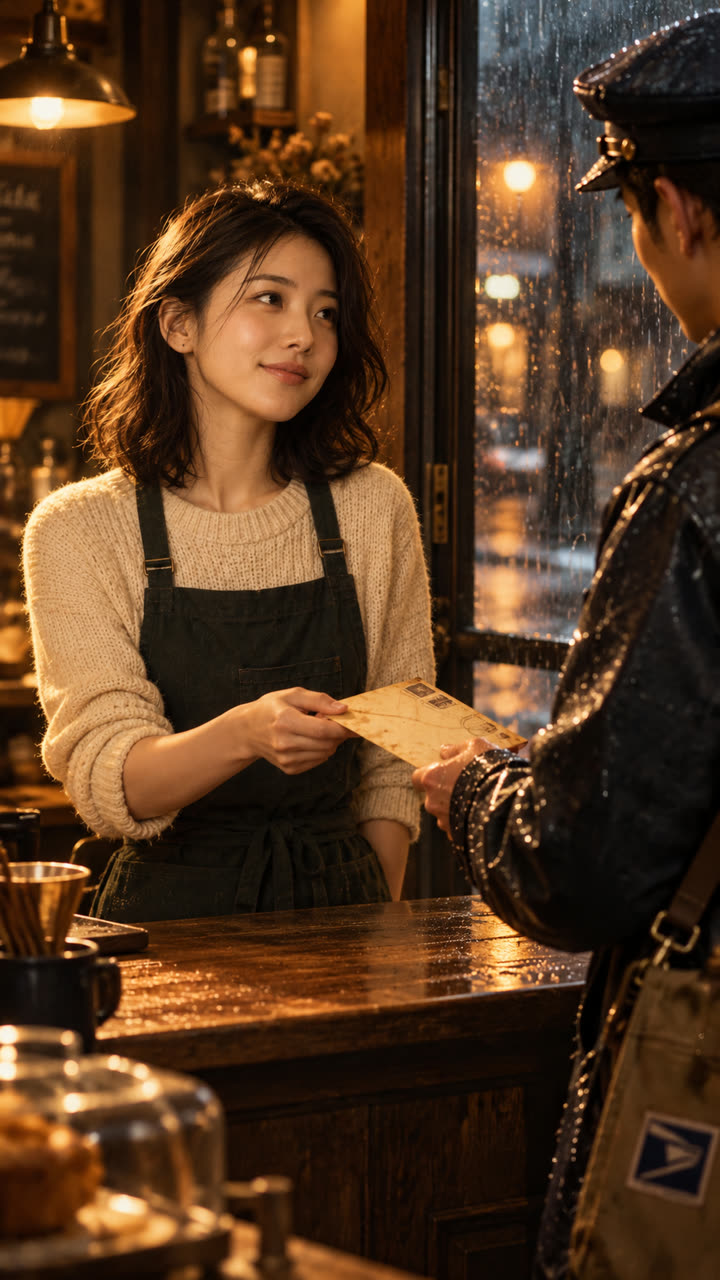
关键帧:收信 5按镜出视频,按镜序拼接
关键帧做首帧,逐镜图生视频,最后按镜序拼成一条。某一镜不行就重做那一镜,不用整集重来。
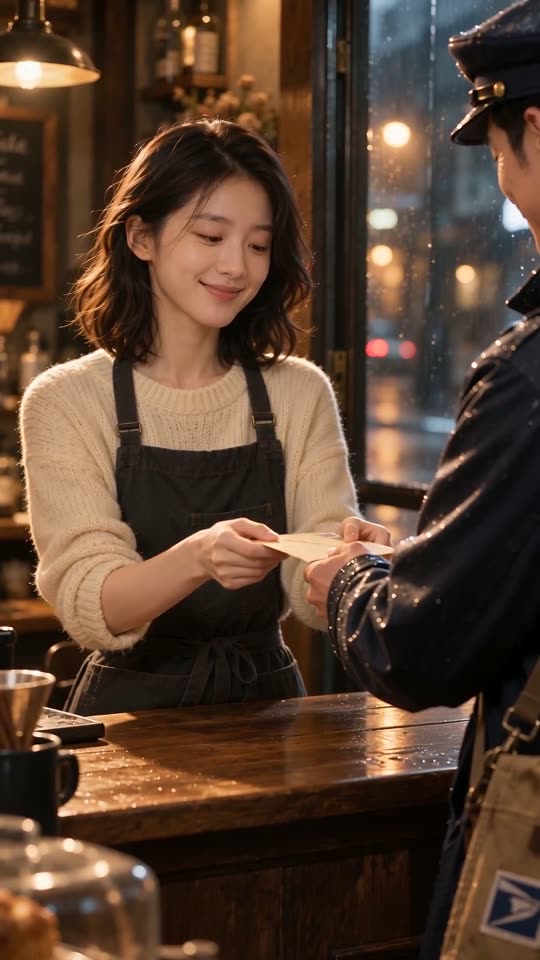
成片截帧
一份好分镜要写清哪些东西
景别:全景交代环境,中景交代动作和关系,近景和特写给情绪和细节。连续几镜都是同一景别,画面会显得平。时长:每镜 4 到 8 秒,情绪镜头可以长一点,动作镜头短一点。
动作要写成看得见的:「她很难过」是拍不出来的,「她捏紧信纸,低下头,肩膀轻轻发抖」才能拍。对白要标明谁说、说给谁。转场写在镜头之间,比如上一镜结尾是她冲出门,下一镜是门外的雨夜街道。
分镜和计费、返工的关系
时长写在每一镜上,整集要生成多少秒视频在出片前就能算出来,费用也好估。返工也以镜为单位:某一镜人物表情不对,只重做这一镜的关键帧或视频,其他镜头不受影响。
建议先批量出关键帧,整集过一遍节奏,确认没问题再批量出视频。改关键帧比改视频便宜得多。
常见问题
分镜能手改吗?
能。自动拆完可以改动作、对白和时长,再生成。也可以直接跟分镜助手说要改哪一镜。
一集多少个分镜合适?
一到两分钟的单集,按每镜 4 到 8 秒算,大约 15 到 30 镜。
分镜可以导出吗?
分镜表支持 JSON 结构化输出:镜号、时长、提示词分字段,便于批量处理和二次编辑。
没有剧本能直接写分镜吗?
建议先有剧本。一句话梗概也可以,先让剧本代理写成剧本,再拆分镜。
分镜和视频提示词是一回事吗?
不完全是。分镜是给人看的镜头设计,提示词是给视频模型的指令。拆分镜时两者一起生成,改分镜后提示词会跟着更新。
接着看
今天就拍出你的第一集
注册即送体验额度。先写一句卖点,或贴一段小说试试。